鹈鹕测试
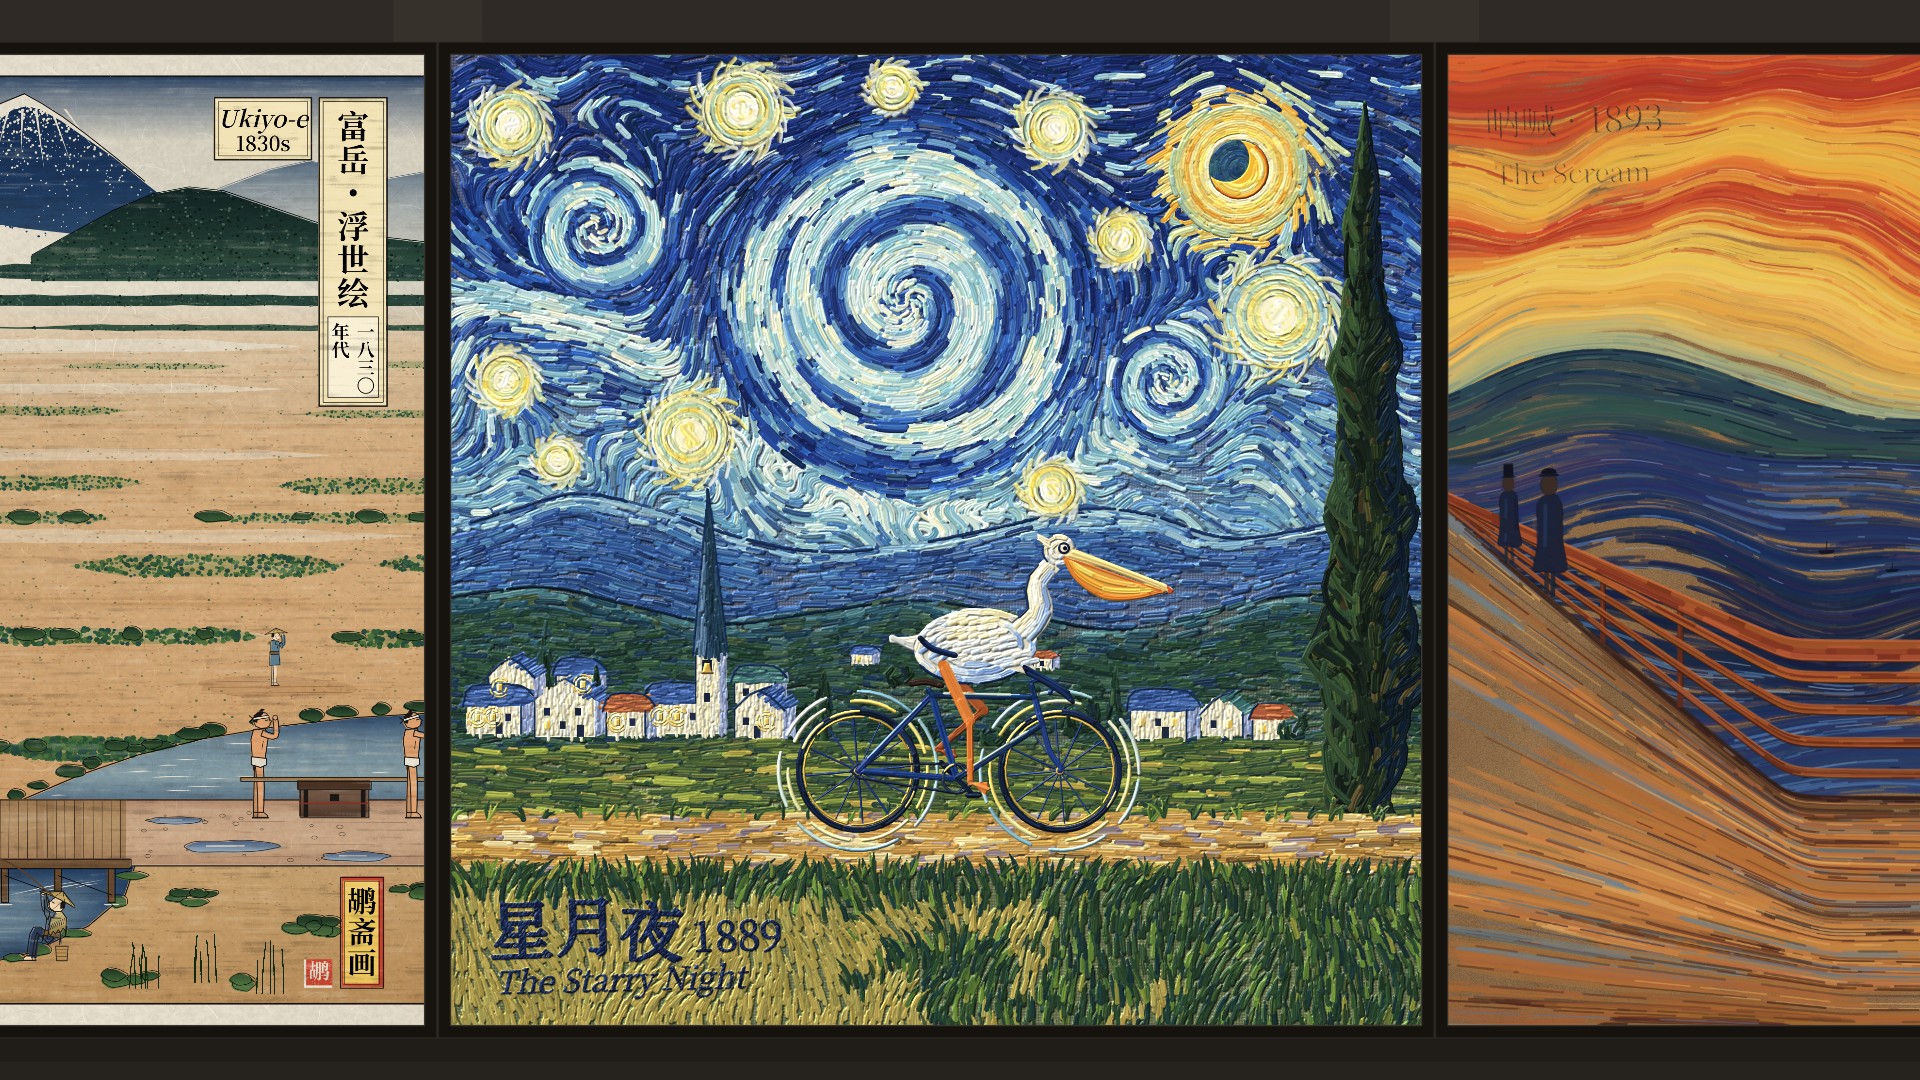
一只鹈鹕骑着自行车,穿过埃及壁画、宋人山水、8-bit 像素、聊天窗口和代码编辑器。 8220 帧画面、整条配乐,全部由代码算出来:没有一张手绘图,没有一秒录音, 也没有一帧是"生成"出来再挑的。
它不是"生成"的,是"算"出来的
程序里没有一张图。整个片子只有一个函数:给它一个时间 t,它还你一帧画面。 车轮转了多少度、鹈鹕的脚踩到哪个位置、云往哪边飘、这一笔墨的浓淡——全是 t 的函数。
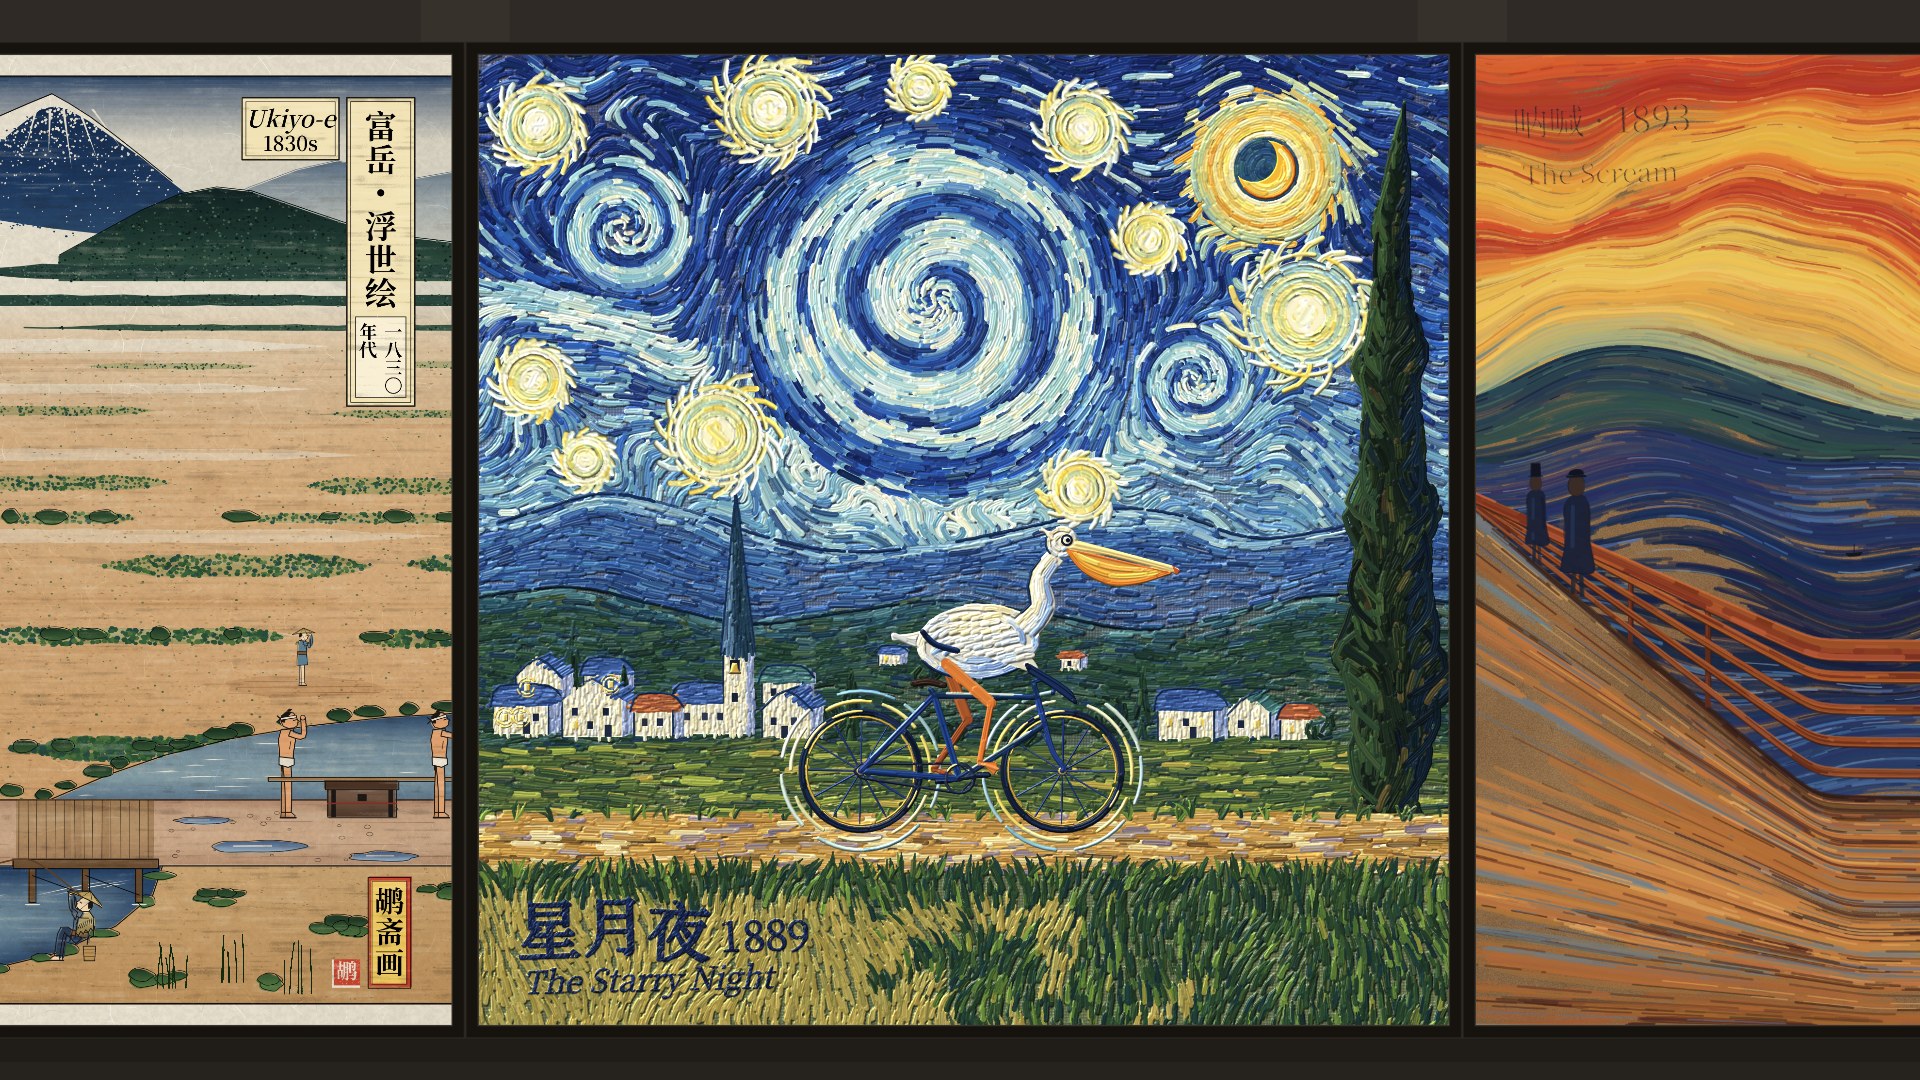
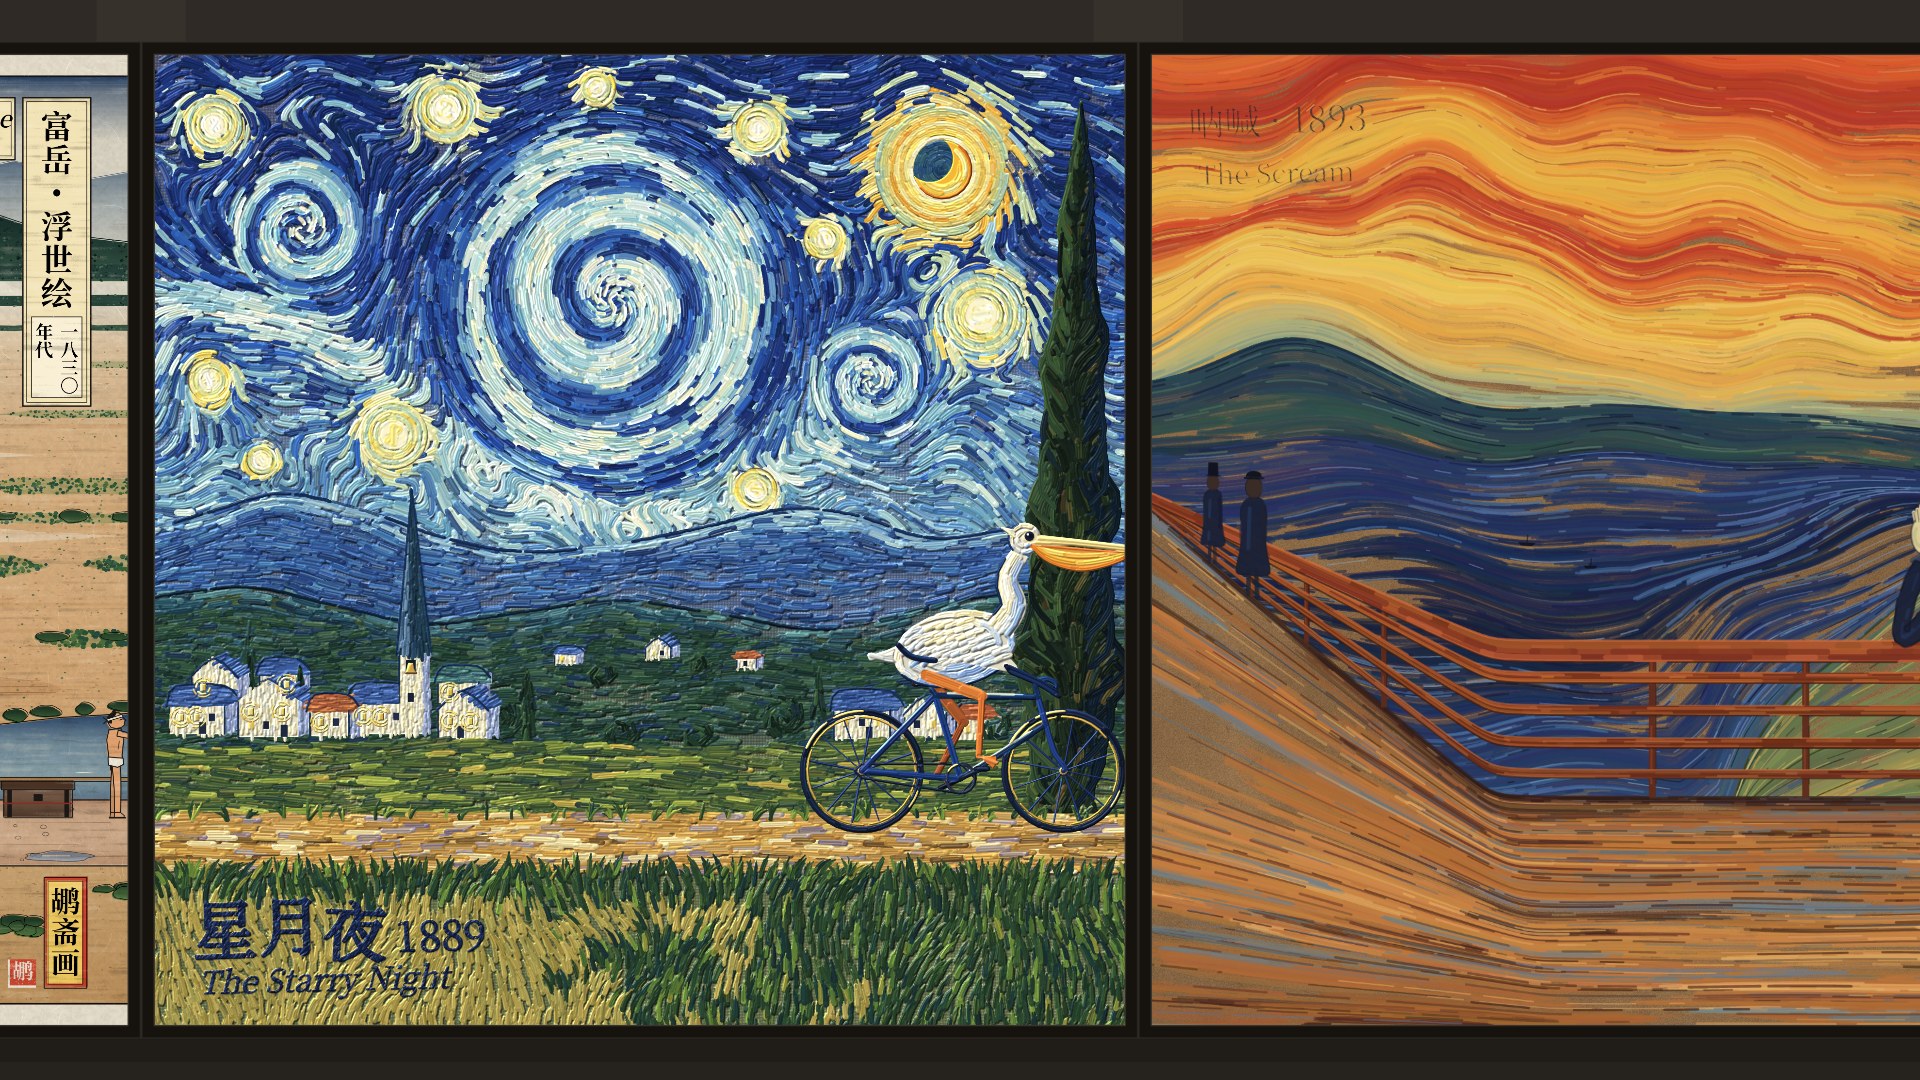
所以同一段代码,取 74 秒和 76 秒,得到的是两张不同的画。 它们不是"两个提示词碰巧像",而是同一套公式在两个时刻的解。
这也解释了为什么整片可以随时重渲:改一个参数,8220 帧全部跟着变, 不需要重新抽卡、不需要祈祷一致性。
画面不是被找出来的,是被算出来的。
// 每一帧都是同一个入口,t 是唯一变量
render(t)  →  camera(t), bike(t), pelican(t), brush(t), palette(era)
// 20 个场景共用一套运动骨架,换的只是画风层
一副骨架,二十种画法
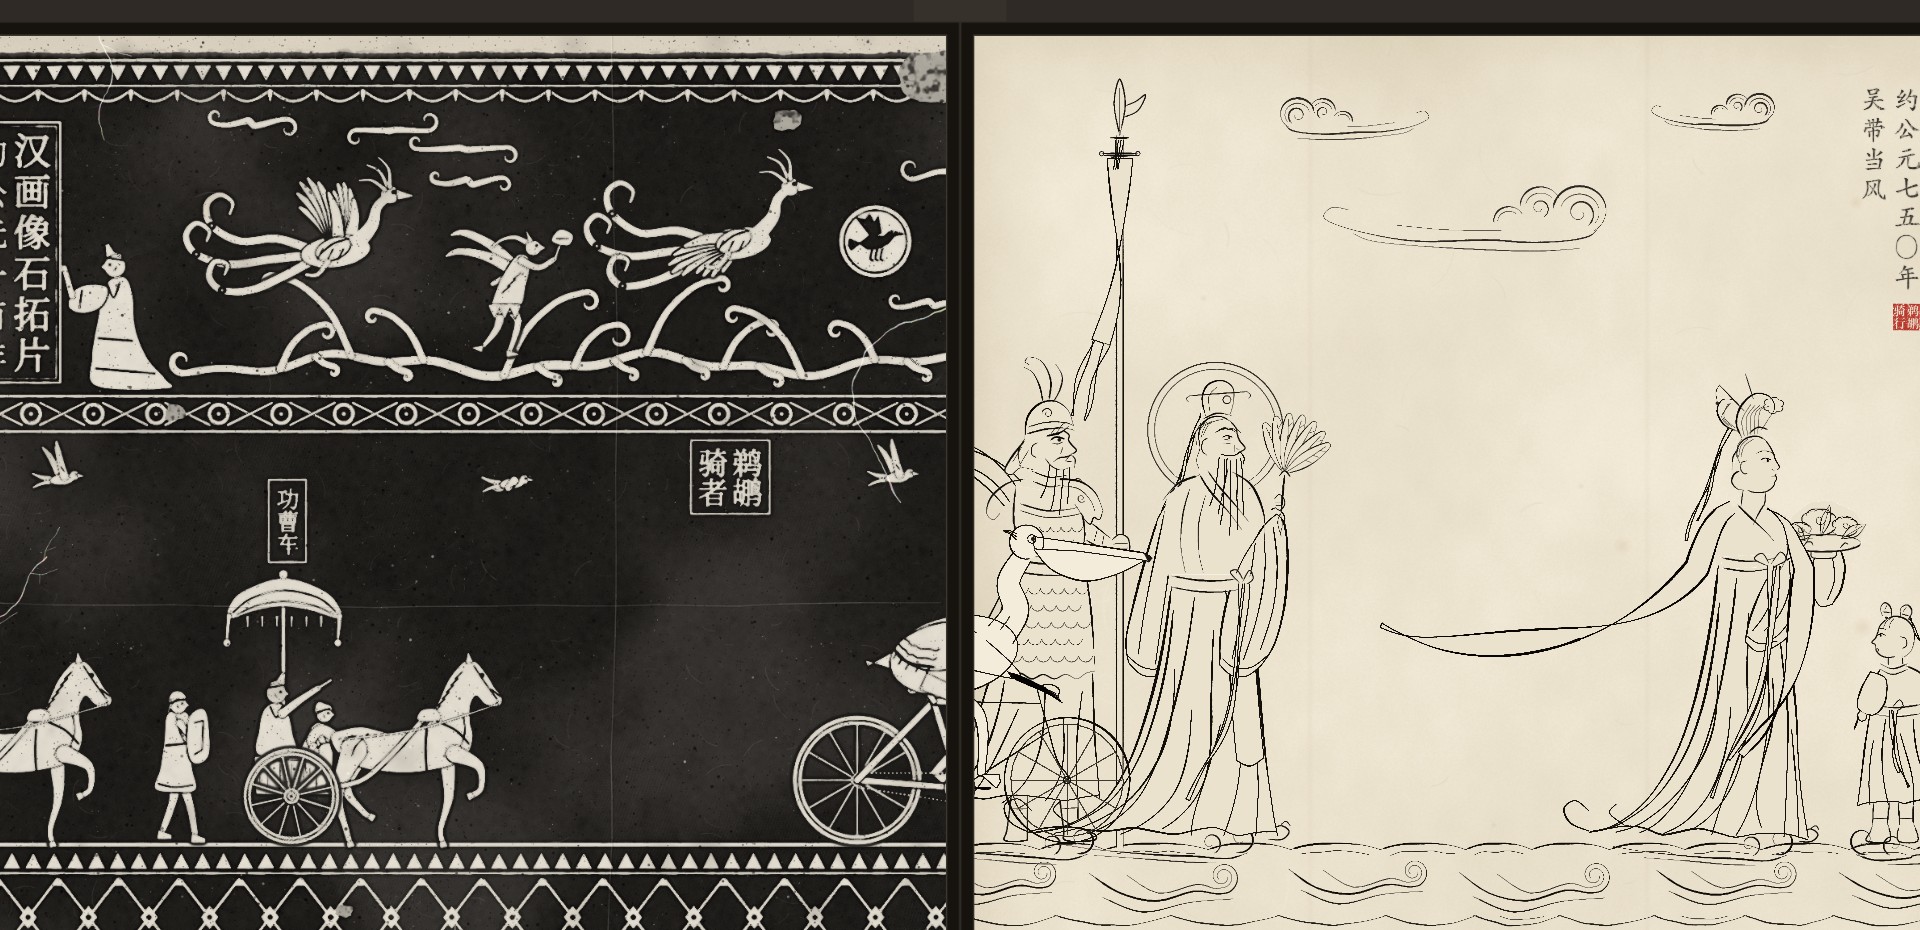
二十个时代不是二十段互不相干的素材,而是同一副运动骨架换了二十层皮: 曲柄的角度、轮子的转速、镜头的横移速度,二十个场景共用同一套定义。
换场景时,变的只有笔刷、配色和纸的质感。所以第 23 秒那一帧能"接上"—— 不是靠剪辑对齐,是因为两边本来就在算同一个动作。
这也是程序化影像和生成式影像最大的分野:前者可以先有结构,再挑风格;后者只能先有画面,再想办法接住。
声音也是算的
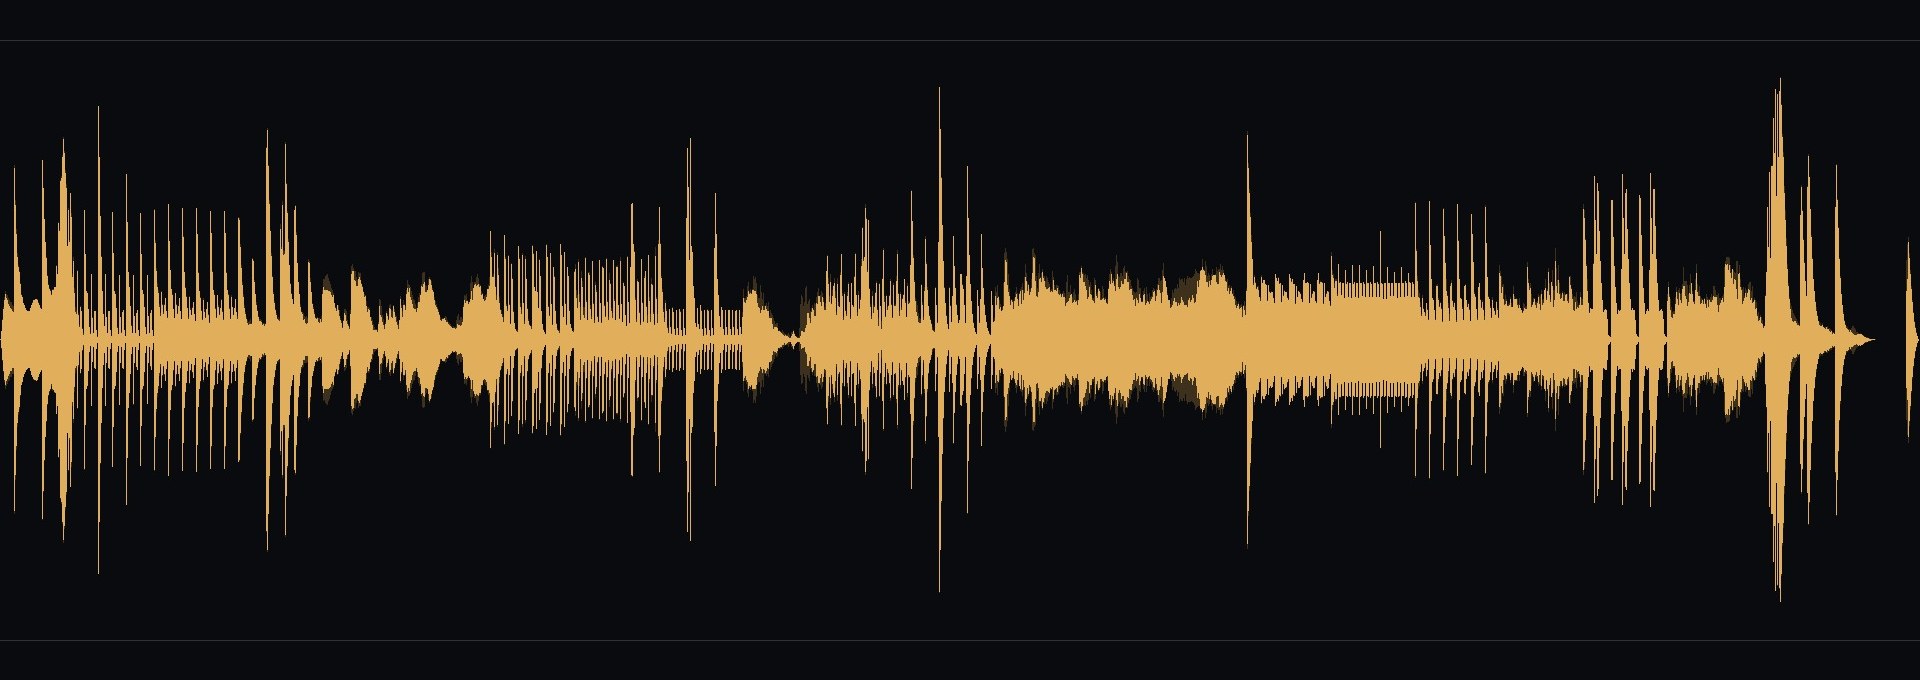
137 秒配乐没有一个采样文件:全部由 Web Audio 在浏览器里离线合成, 鼓、贝斯、和声都是一条条振荡器叠出来的。
节奏和画面共用一张时间表——120 BPM,一小节 2 秒,一个场景 6 秒。 场景切换落在小节线上,强拍落在车铃上;所以车铃一响,时代就翻页。
音频不是"配上去"的,它和画面读的是同一组常量。
// 时间表(节选):画面与声音共用
BPM = 120    bar = 2s    scene = 3 bars = 6s
// 强拍 → 车铃;场景边界 → 换画风
模型怎么干活
这部片子的代码由一个模型写成,但它的活不是"画二十幅画",而是造一条能反复出片的产线。 动作只有三步,每一步都是为了让人能验收。
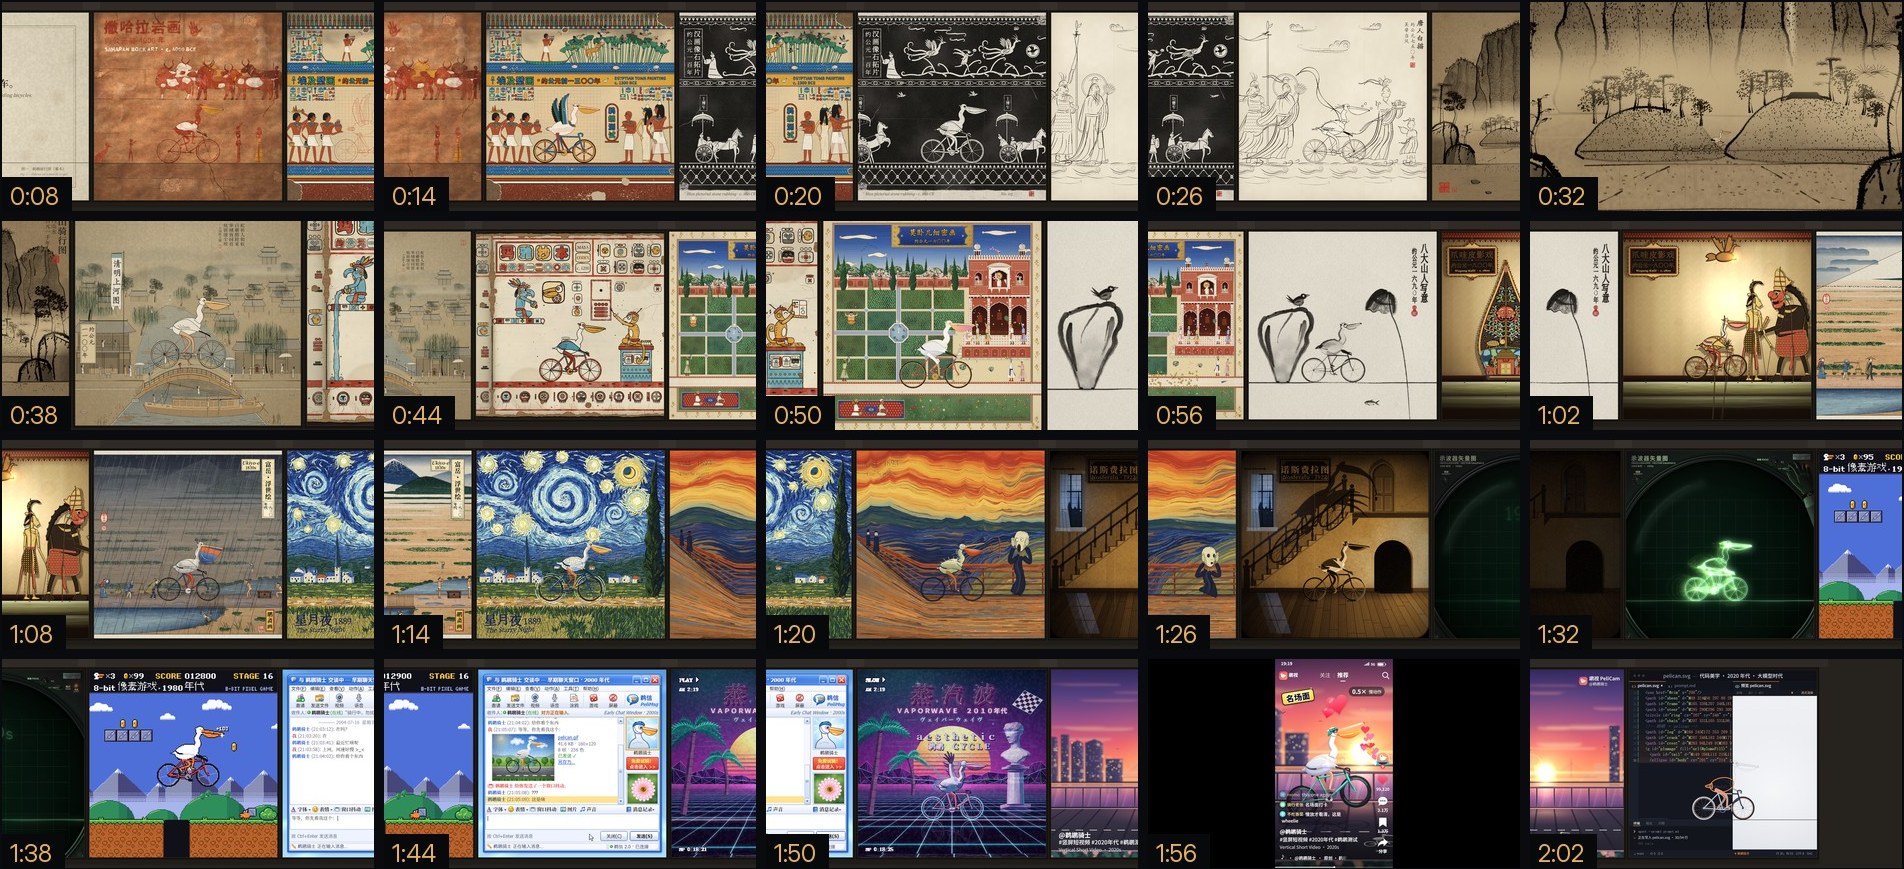
先写简报:二十个场景,每个一句话,定死时代、画风、动作。 再让每个场景成为独立文件,可以单独跑、单独改。 最后把二十个场景拼成一张接触表——一屏看完,哪一格崩了立刻看见,不用等全片渲完。
简报
二十个场景,每个一句话:时代、画风、动作、镜头。写不清楚的地方,后面一定会崩。
场景
一个场景一个文件,共用运动骨架。单独能跑,才谈得上单独能改。
自检
拼接触表,逐格看取景、遮挡、笔刷有没有破。人定标准,模型写实现。
为什么把它单列一类
市面上的 AI 视频,主流做法是"抽卡":写提示词,等模型吐一段,不满意再抽。 抽出来的片子不可改、不可复用,也很难解释清楚它为什么长这样。 这部片子走的是另一条路:写一个能画出任意时刻的程序。
提示词 → 一段视频
得到的是结果。想改一处,整段重抽;想换风格,一致性重新赌一次;想讲原理,只能讲"模型学的"。
写程序 → 任意时刻的画面
得到的是方法。参数可改、整片可重渲、每一帧都能指着说清它是怎么来的——也能拆开讲给别人听。
所以 AI 实验室单开一格「代码影像」:这里的作品不是用 AI 做出来的视频, 而是用代码生成、可以逐帧复盘的影像。判断标准只有一条—— 能不能把任意一帧的来源讲清楚。